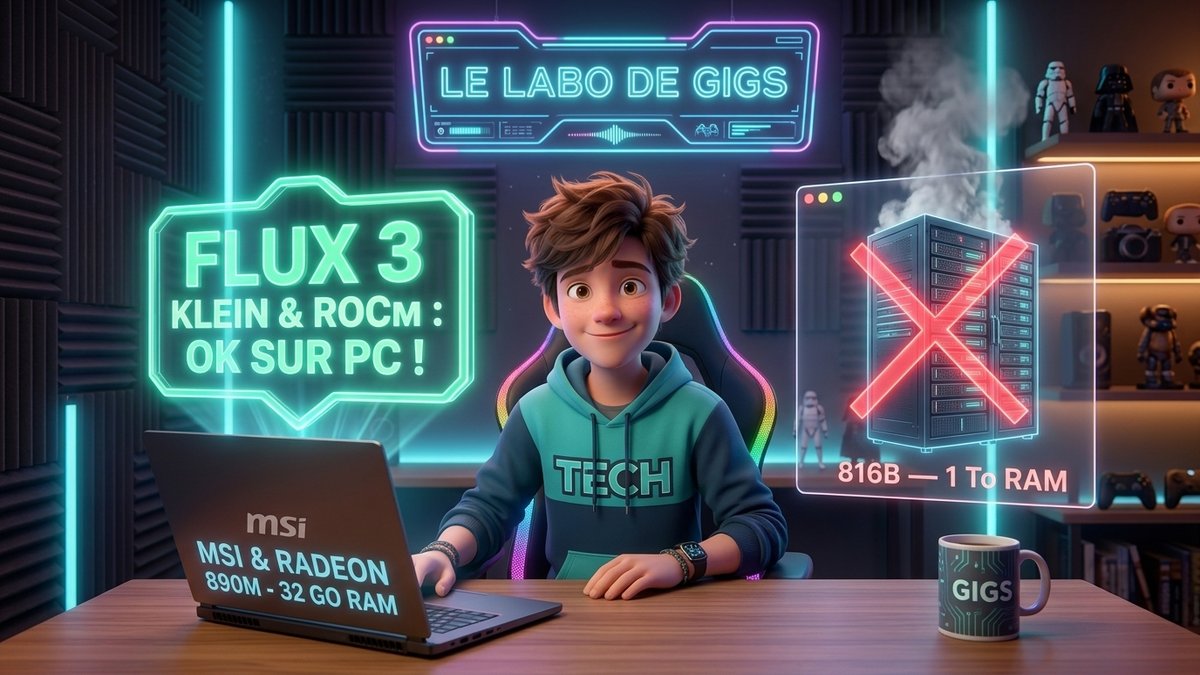
Le coup de gueule amical de Gigs : « Attention au mot "Open-Weight" (poids ouverts) dans les titres de presse ! Quand un laboratoire publie un modèle "ouvert" de 500 ou 800 milliards de paramètres, c’est génial pour la recherche… mais il faut entre 273 Go et 1 To de mémoire pour le charger ! Ici au Labo, avec KVH, notre règle est simple : vous dire honnêtement oui ou non si ça rentre dans un vrai PC de maison (16 à 32 Go de RAM). »
En un coup d’œil : ce qu’il faut retenir de la semaine
Les vraies bonnes nouvelles pour nos PC
- Radeon 890M (gfx1150) sous ROCm : support officiel sur Windows 11 25H2 et Ubuntu, fini la lenteur de DirectML dans ComfyUI !
- FLUX 3 Image Klein (5,6B) : génération d’images locale compacte, disponible en FP8 et GGUF (idéal sur 32 Go de RAM).
- JetBrains Mellum 2.1 & MiniCPM-V-4.7 : des modèles ultra-légers (2,5B à 3B actifs) qui tournent à toute vitesse en local.
- Ollama 0.40.2 à 0.40.6 : correction des processus bloqués sous Windows, modèles de décision et mise à jour automatique vers llama.cpp.
Ce qui ne tournera pas à la maison
- Meta Muse Spark Open (816B) : réclame près de 1 To de mémoire unifiée (taillé pour un Mac Studio M5 Ultra hors de prix).
- Reflection Beam 1.0 (501B) : même compressé en NVFP4, il pèse 273 Go (prévu pour 4 cartes serveur NVIDIA B300).
- Formats NVFP4 et INT8 : taillés d’abord pour NVIDIA ; sur un PC AMD Ryzen AI, privilégiez toujours le FP8 ou le GGUF.
1. Modèles de langage (LLM) : le tri d’octobre 2026
Voici le récapitulatif des sorties repérées jusqu’au 17 octobre 2026, avec la question qui compte vraiment : est-ce que ça tourne sur un ordinateur personnel ?
| Modèle | Date | En bref | Pour un PC maison ? |
|---|---|---|---|
| Meta Muse Spark Open | 15 oct. 2026 | 816B paramètres (42B actifs), contexte 1M, multimodal, code et agents. Licence Muse (restrictions commerciales). | Non : ~1 To de mémoire requis (ciblé Mac Studio M5 Ultra). |
| Reflection Beam 1.0 | 16 oct. 2026 | MoE 501B / 23B actifs, licence Apache 2.0, contexte 1M. Versions FP8 et NVFP4 (273 Go). | Non : calibré pour 4× GPU serveur NVIDIA B300. |
| JetBrains Mellum 2.1 | 8 oct. 2026 | Spécialisé code, architecture MoE 12B avec seulement 2,5B actifs, Apache 2.0. | Oui, sans effort : très fluide sur un PC portable 16 ou 32 Go. |
| Aleph Alpha Kolibri-1 | 3 oct. 2026 | 78B au total mais seulement 3,5B actifs par jeton, licence Apache 2.0. | Possible uniquement sur une machine dotée de beaucoup de RAM (64 Go+). |
| Jais 3 (IFM / MBZUAI) | 15 oct. 2026 | Famille de 6 modèles allant de 0,9B à 375B de paramètres. | Oui pour les petites tailles (0,9B à 13B). |
| Mistral Large 4 | Fin oct. (annoncé) | Environ 1 000 milliards (~1T) de paramètres, poids promis d’ici fin octobre. | Non (modèle pour centre de données). |
Du côté d’Ollama (versions 0.40.2 à 0.40.6) et de Hugging Face
- Nouveaux venus dans Ollama : arrivée de NVIDIA Nemotron 3.5 Super (120B, vision) et de sa petite sœur Nemotron 3.5 Bolt, ainsi que des Decision Models (modèles rapides pour répondre oui/non, trier ou classer un texte selon vos critères).
- Correctifs bienvenus sous Windows : fini les processus Ollama fantômes qui restaient bloqués en tâche de fond ! Les anciens modèles téléchargés sont aussi mis à jour proprement pour rester compatibles avec
llama.cpp(avec sauvegarde automatique). - Trois pépites repérées sur Hugging Face & LocalLLaMA :
- EmbeddingGemma-2 (Google, Apache 2.0) : transforme textes, images, audio et vidéo en vecteurs de recherche (embeddings) et peut même tourner directement dans le navigateur via WebGPU.
- MiniCPM-V-4.7-35B-A3B : un modèle capable de lire des images avec seulement ~3 milliards de paramètres actifs !
- Le clin d’œil geek de la semaine : un bricoleur sur Reddit affirme avoir fait tourner Qwen 27B à 20 tokens/seconde sur la puce graphique d’une PlayStation 5 modifiée (non vérifié par le Labo, ne démontez pas votre console !).
2. Génération d’images locale : FLUX 3 Image Klein entre en scène
Créer des illustrations sur son propre PC sans payer d’abonnement devient beaucoup plus accessible grâce aux modèles compacts de 5 à 7 milliards de paramètres :
| Modèle image | Date | Taille | Licence | L’avis du Labo |
|---|---|---|---|---|
| FLUX 3 Image Klein (Black Forest Labs) | 15 oct. 2026 | 5,6B (~20 Go en BF16, ~6-8 Go en FP8/GGUF) | FLUX Kommunity (gratuit non-commercial ; commercial autorisé sous 5 M$ de CA) | Le meilleur choix actuel : existe en FP8, INT8, NVFP4 et version distillée en 16 étapes. |
| Qwen-Image 2.1 Turbo (Alibaba) | 9 oct. 2026 | 7B (~32 Go en BF16) | Recherche uniquement (non commercial) | Génération et retouche en 8 étapes, mais gourmand : réservé aux grosses configurations (même en GGUF/FP8). |
| Z-Image Turbo | Déjà dispo | ~6B | Ouverte | Le plus simple pour débuter sur AMD : modèle prêt à l’emploi intégré dans ComfyUI avec guide officiel AMD. |
Côté matériel : AMD a aussi lancé mi-octobre sa station Ryzen AI Halo 192 Go (environ 7 300 $ sous Linux), capable d’allouer jusqu’à 160 Go à la mémoire vidéo pour faire tourner FLUX et de la vidéo dans ComfyUI. Une vitrine impressionnante, mais hors budget pour un particulier.
3. Guide pratique : activer ROCm sur un PC portable AMD Radeon 890M (32 Go RAM)
Le retour d’atelier de KVH : « Mon ordinateur portable de travail (le MSI Prestige A16 AI+ qui m’a servi pour le guide sur le NPU) est équipé du processeur AMD Ryzen AI 9 HX 370, de la puce graphique intégrée Radeon 890M (architecture gfx1150) et de 32 Go de RAM. Jusqu’ici, pour générer des images sous Windows, il fallait passer par DirectML, souvent lent. Désormais, la Radeon 890M (gfx1150) est officiellement prise en charge par AMD ROCm sur Windows 11 25H2 (et Ubuntu 24.04/26.04) ! »
Les 5 étapes pour en profiter sur votre PC Ryzen AI (Radeon 890M)
- Mettre à jour le pilote AMD Adrenalin : installez la version compatible ROCm (la matrice officielle AMD indique le pilote 26.10.41.05 ou supérieur sur Windows 11 25H2).
- Allouer plus de mémoire vidéo (VGM) : ouvrez AMD Software : Adrenalin Edition → Performance → Réglages → Variable Graphics Memory (VGM). Avec 32 Go de RAM (la quantité recommandée par AMD), vous pouvez transformer une partie de votre mémoire vive en mémoire vidéo dédiée (par exemple 16 Go) pour charger les modèles sans saturer.
- Installer ComfyUI Desktop en mode ROCm : téléchargez ComfyUI Desktop et sélectionnez explicitement le moteur AMD ROCm lors de l’installation.
- Faire un premier essai avec Z-Image Turbo : utilisez le modèle prêt à l’emploi Z-Image Turbo inclus dans les modèles de départ de ComfyUI pour valider que l’accélération ROCm fonctionne bien.
- Passer à FLUX 3 Image Klein en FP8 ou GGUF : une fois le pipeline validé, chargez FLUX 3 Klein (version FP8 ou GGUF). Évitez Qwen-Image 2.1 en pleine précision (32 Go), trop lourd pour une puce intégrée.
Trois conseils importants avant de lancer vos rendus
- Choisissez toujours FP8 ou GGUF sur AMD : les variantes NVFP4 et INT8 sont avant tout optimisées pour les cartes NVIDIA récentes. Sur Radeon 890M, le FP8 ou le GGUF offrent la meilleure compatibilité.
- Patience sur le temps de rendu : lorsque les blogs d’AMD annoncent « moins de 30 secondes par image », ce chiffre est mesuré sur la grosse station Ryzen AI Halo. Sur une puce portable Radeon 890M, le calcul prendra plus de temps, mais il se fera 100 % gratuitement et hors ligne sur votre machine !
- Astuce pour
stable-diffusion.cpp: si vous utilisez l’outil léger en ligne de commandestable-diffusion.cppsur une Radeon 890M (gfx1150), pensez à ajouter l’option--diffusion-fa(Flash Attention) pour éviter une erreur connue de la bibliothèque rocBLAS.
4. Sources et liens vérifiables (collecte du 17 octobre 2026)
Comme toujours sur L’IA, c’est simple, voici l’ensemble des publications techniques et dépôts officiels qui nous ont permis de vérifier ces informations :
- Matrice officielle de compatibilité AMD ROCm (support gfx1150 / Radeon 890M)
- Guide officiel AMD Developer Playbook : ComfyUI + Z-Image Turbo
- Suivi technique GitHub ROCm / TheRock pour l’architecture gfx1150
- Présentation de FLUX 3 Image Klein (5,6B, poids ouverts) sur Unite.AI et comparatif technique FLUX 3 Klein vs Qwen-Image 2.1 Turbo
- Annonce de Meta Muse Spark Open (TechCrunch, 15 octobre 2026)
- Publication des poids de Reflection Beam 1.0 (501B MoE, 16 octobre 2026)
- Notes de version officielles d’Ollama (0.40.2 à 0.40.6, octobre 2026)